Что такое XYZ-анализ
XYZ-анализ отвечает на один вопрос: насколько ровно продаётся каждая позиция из вашего списка.
Не «сколько», а именно «насколько ровно». Две позиции могут давать одинаковую выручку за год и вести себя при этом совершенно по-разному: одна расходится примерно одинаково каждый месяц, вторая половину года стоит, а потом уходит разом. Деньги одинаковые, а работа с ними — разная.
Метод берёт продажи по периодам — месяцам, неделям, кварталам — и делит позиции на три группы:
- X — спрос ровный, будущее предсказуемо;
- Y — колеблется, но в понятных пределах;
- Z — рвано, планировать по среднему нельзя.
Ценность не в самих буквах, а в том, что после анализа список перестаёт быть однородным. Под X можно держать меньший запас и заказывать по расписанию. Под Z запас либо страховой и дорогой, либо его нет и вы миритесь с отказами. Решение разное, и до анализа его принимают по всему ассортименту одинаково.
Почему среднего недостаточно
Возьмём две позиции и посмотрим продажи по кварталам.
Первая: 100, 105, 95, 100 штук. Вторая: 40, 10, 210, 140 штук.
Среднее у обеих одинаковое — 100 штук за квартал. Отчёт, в котором есть только среднее, покажет две одинаковые строки. Между тем это два разных бизнеса в одной таблице: первую позицию можно заказывать по графику и держать минимальный запас, а вторая один квартал почти не продавалась, а в следующий ушла в пять раз больше.
XYZ-анализ измеряет именно эту разницу — насколько сильно значения разбегаются вокруг своего среднего. У первой позиции разброс получится 3,5 %, у второй — 79,7 %. Первая попадёт в X, вторая в Z.
Само число называется коэффициентом вариации, и считается оно проще, чем кажется.
Как считается
Шагов три, и каждый можно проверить на калькуляторе.
- Считаем среднее за все периоды.
- Считаем стандартное отклонение — насколько в среднем значения отходят от этого среднего.
- Делим одно на другое и переводим в проценты.
Последнее действие и есть коэффициент вариации:
CV = σ / μ × 100 %
- CV
- коэффициент вариации, разброс в процентах от среднего
- σ
- стандартное отклонение продаж по периодам
- μ
- среднее значение продаж за период
Деление на среднее здесь главное. Без него разброс измерялся бы в штуках, и позицию, которая продаётся тысячами, нельзя было бы сравнить с той, что расходится десятками. А в процентах от собственного среднего они сравнимы: 8 % — это ровно и для той, и для другой.
Стандартное отклонение считается так:
σ = √( ( (x₁ − μ)² + (x₂ − μ)² + … + (xₙ − μ)² ) / N )
- xᵢ
- продажи в периоде номер i
- μ
- среднее за все периоды
- N
- сколько всего периодов
Обратите внимание на деление на N, а не на N − 1. Это так называемая генеральная форма: мы описываем именно те периоды, которые есть в файле, а не оцениваем по выборке поведение чего-то большего. Инструмент считает так же — и если вы сверяете его расчёт с Excel, берите СТАНДОТКЛОНП (в английской версии STDEVP), а не СТАНДОТКЛОН. На двенадцати месяцах разница между ними заметная: примерно 4 %.
Проверим на второй позиции из примера выше. Среднее — 100. Отклонения: −60, −90, +110, +40. Квадраты: 3600, 8100, 12 100, 1600. Их сумма 25 400, делим на 4 периода — 6350, корень — 79,7. Делим на среднее 100 и получаем 79,7 %.
X, Y и Z: откуда берутся пороги
Получив процент по каждой позиции, остаётся разложить их по группам. Границы по умолчанию такие:
- X — коэффициент вариации меньше 10 %;
- Y — от 10 % до 25 %;
- Z — 25 % и выше.
Эти числа — отраслевая договорённость, а не закон природы, и в вашем случае они могут оказаться не теми. Смысл у них простой. До 10 % колебания не мешают планировать: отклонение укладывается в обычный страховой запас. После 25 % среднее перестаёт что-либо предсказывать — заказывать «как обычно» уже нельзя.
Менять границы стоит, когда результат перестаёт различать позиции. Если в X попало три позиции из двухсот, а всё остальное оказалось в Z, отчёт не говорит ничего — поднимите пороги и посмотрите, где данные сами распадаются на группы. И наоборот: продажи по неделям колеблются сильнее, чем по месяцам, просто потому, что период короче, — на недельных данных пороги обычно выше.
В демонстрационной выгрузке при границах по умолчанию получилось так: 40 позиций в X, 42 в Y и 38 в Z. Коэффициент вариации в X — от 4 до 8,6 %, в Y — от 13,1 до 21,5 %, в Z — от 32,3 до 111,5 %.
Что подавать на вход
Файл устроен просто: строка — позиция, столбцы — периоды.
- Название или артикул — чтобы строку можно было опознать.
- Числовые столбцы по периодам: январь, февраль, март и так далее. Это могут быть штуки, литры, деньги — важно, чтобы во всех столбцах была одна и та же величина.
- Столбцы идут в хронологическом порядке — слева направо.
Последнее — не пожелание к аккуратности, а требование. Инструмент не пытается угадать хронологию по названиям столбцов: он берёт их в том порядке, в котором вы их выбрали. Для самого коэффициента вариации порядок безразличен, но по тем же данным считается всё остальное — рост, спад, сезон, — и там перепутанный порядок даёт неверный ответ молча.
В выбранных столбцах не должно быть пустых ячеек. Инструмент проверяет их перед расчётом, и если находит пропуск, дальше не идёт: показывает список таких строк и оставляет вас на шаге выбора столбцов. То же самое будет с прочерком, «н/д» и любой другой пометкой словами — для расчёта это не число.
Чинится это одним действием: в пустую ячейку ставится ноль. Месяц без продаж — это факт, а не отсутствие данных, и ноль говорит ровно это. А вот подставлять вместо пропуска среднее не нужно — почему, разберём в частых ошибках.
Ноль продаж — это не Z
Отдельно про позицию, которая не продавалась ни разу.
У такой строки среднее равно нулю, а значит, делить на него нельзя — коэффициент вариации для неё не существует. Инструмент не выдаёт ошибку и не пишет вместо него ноль: позиция просто остаётся без класса. Она есть в отчёте, её видно, но ни в X, ни в Y, ни в Z её нет.
Это сделано намеренно. Отнести такую позицию к Z значило бы сказать «спрос непредсказуем», хотя сказать про неё нечего вообще: спроса не было. А ноль вместо коэффициента поставил бы её в один ряд с самыми ровными позициями ассортимента — то есть ровно наоборот.
Практический вывод: если позиций без класса много, это диагноз самой выгрузке. Скорее всего, в файл попал полный справочник номенклатуры вместо тех позиций, которыми вы действительно торговали.
Сколько периодов нужно
Формально коэффициент вариации считается и по трём числам. Практически три точки не говорят почти ничего: одна случайная распродажа — и позиция уезжает в Z.
Разумный минимум — 12 периодов, то есть год по месяцам. Это даёт две вещи сразу: устойчивый разброс и возможность увидеть сезон. Если периодов меньше, помните, что вы смотрите на срез, а не на поведение позиции.
И наоборот, слишком длинный период мешает: продажи за три года покажут «ровно» там, где в первый год позиция продавалась вдвое хуже, чем в третий. Тогда лучше сравнить два годовых расчёта между собой, чем считать один на всю историю.
Как читать отчёт
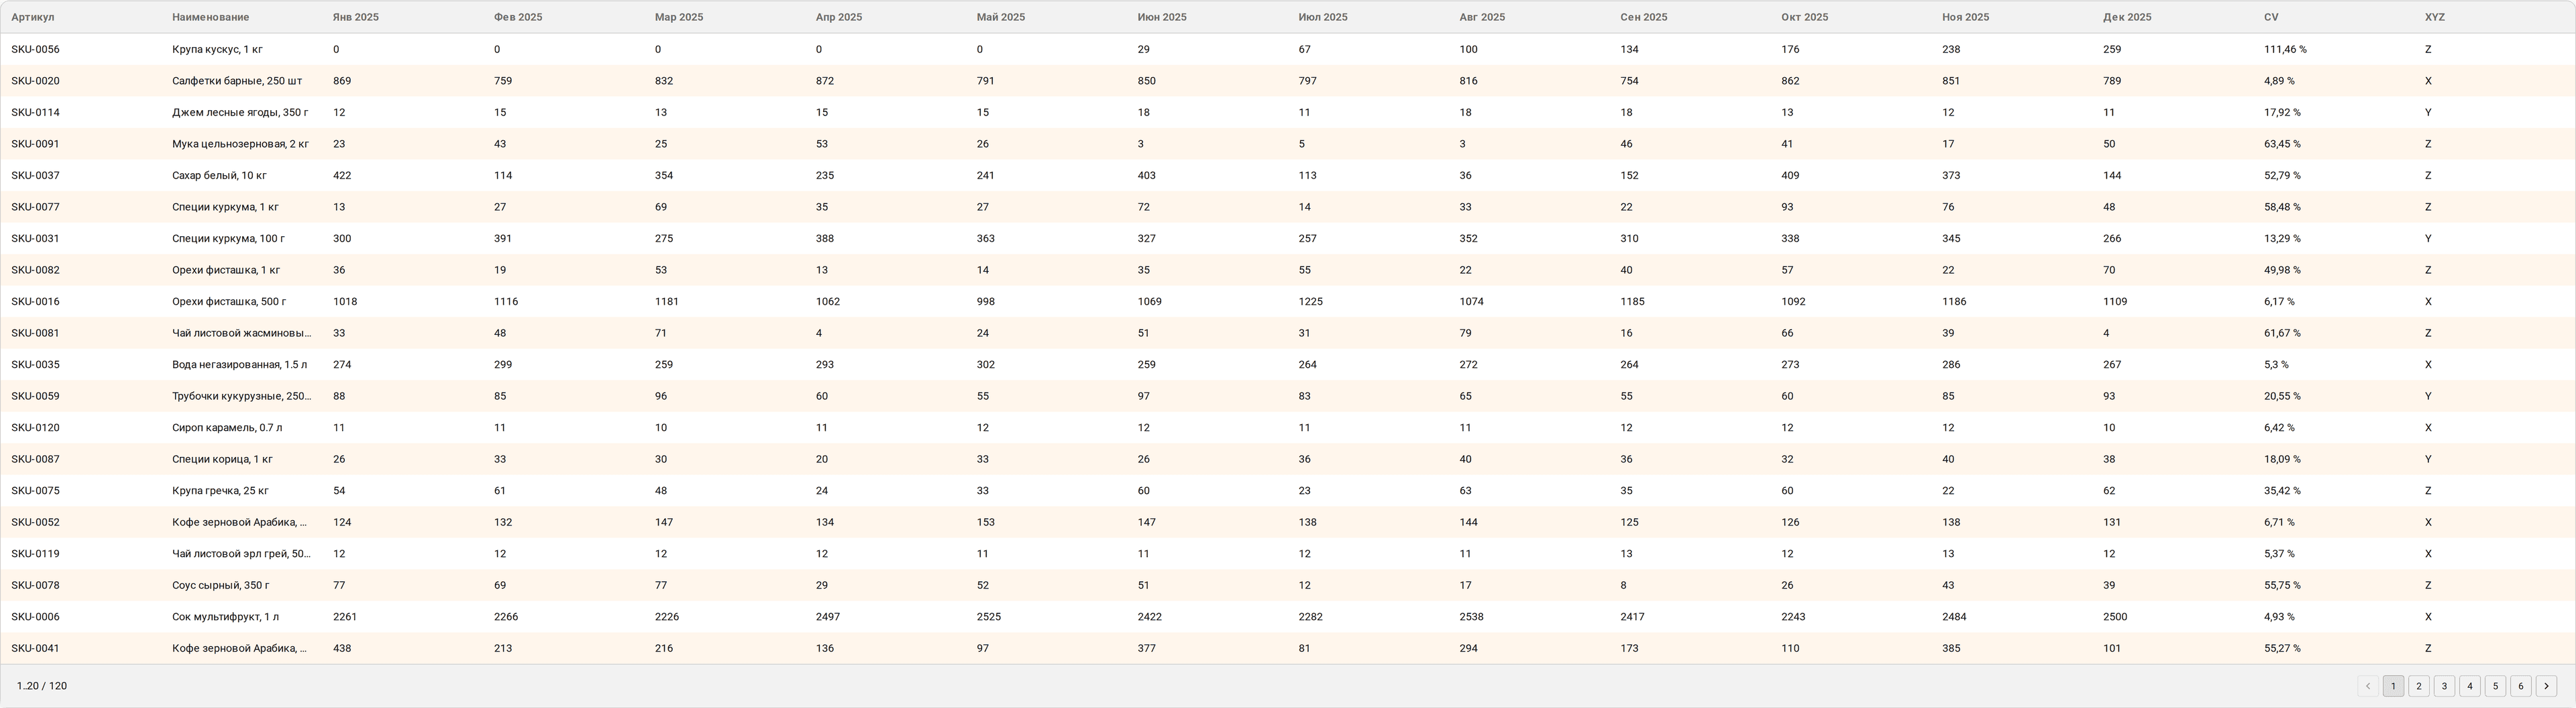
В отчёте к вашим столбцам добавляются два: коэффициент вариации и класс. Всё остальное — ваш файл в неизменном виде, строка к строке.
Читать его стоит в таком порядке.
- Сначала распределение по классам целиком. Сколько позиций в каждой группе — это картина ассортимента. Если в Z больше трети позиций, дело, скорее всего, не в них, а в периоде наблюдения или в самих данных.
- Потом Z по убыванию объёма. Крупная позиция с рваным спросом — это замороженные деньги и риск одновременно, и именно с неё начинается работа.
- Потом X. Это кандидаты на сокращение запаса и на автоматический заказ: по ним планирование работает.
Чего в отчёте искать не надо — прогноза. XYZ-анализ не говорит, сколько вы продадите в следующем месяце. Он говорит, можно ли вообще полагаться на средние продажи этой позиции, и это другой, более скромный и куда более надёжный ответ.
Что делать с каждым классом
X — ровный спрос. Держите меньший запас и заказывайте по расписанию. Здесь работает автоматизация: точка заказа, минимальный остаток, регулярная поставка. Сэкономленные на складе деньги берутся в основном отсюда.
Y — колеблется в понятных пределах. Страховой запас нужен, но небольшой. Стоит посмотреть, откуда колебание: если оно повторяется из года в год, это сезон, и его можно планировать; если нет — это просто неровный спрос.
Z — рвано. Здесь выбор осознанный, и он всегда компромисс. Либо вы держите дорогой страховой запас, либо миритесь с тем, что позиции временами не будет, либо работаете под заказ. Что нельзя — так это применять к Z те же правила, что к X: именно из этого получаются и переполненный склад, и отказы одновременно.
И общее правило: чем крупнее позиция, тем дороже ошибка. Поэтому XYZ почти никогда не применяют в одиночку — его соединяют с ABC-анализом, который делит тот же список по вкладу в результат. Об этом — следующая статья серии.
Частые ошибки
Сравнивать коэффициенты вариации разных величин. Разброс продаж в штуках и разброс выручки в деньгах — это два разных числа, и класс по ним может выйти разный. Считайте по одной величине.
Считать Z синонимом «плохо». В Z попадает всё, что колеблется, — в том числе сезонные позиции и новинки, которые только начали продаваться. В демонстрационной выгрузке из 38 позиций класса Z три оказались сезонными, две растут, одна затухает и одна перестала продаваться совсем. Это шесть разных решений, а буква у них одна.
Пример из той же выгрузки. Самая крупная позиция ассортимента — кофе в зёрнах, который в июне–августе даёт 56,3 % своих годовых продаж. Её коэффициент вариации 76,8 %, то есть она уверенно в Z. Но спрос на неё не «непредсказуем» — он предсказуем отлично, просто не по среднему за год. XYZ-анализ этого различия не делает: он видит разброс и не видит, что разброс сложился в сезон. Как инструмент отделяет сезон от рваного спроса — в третьей статье серии.
Заполнять пропуски средним. Заполнить их придётся — без этого инструмент не начнёт расчёт, — но подставляют туда среднее, чтобы «не портить статистику», и добиваются ровно обратного: позиция, которой полгода не было в наличии, выглядит ровно продающейся, а её разброс — меньше настоящего. Правильное значение — ноль.
Считать по слишком коротким периодам. Недельные продажи колеблются сильнее месячных просто по природе, а не потому, что спрос хуже. На недельных данных пороги нужны свои.
Что дальше
XYZ отвечает на вопрос «насколько предсказуемо». ABC-анализ отвечает на другой — «сколько это даёт». По-настоящему решения принимаются на пересечении: позиция, которая даёт много денег и при этом ведёт себя непредсказуемо, требует внимания в первую очередь, а ровный хвост не требует почти никакого.
- Что такое ABC-анализ — простыми словами — вторая половина той же картины;
- XYZ+ABC: девять ячеек вместо трёх классов — как соединить оба анализа и что делать с каждой ячейкой;
- Что ещё инструмент видит в ваших периодах — тренд, сезонность и мёртвый запас за теми же цифрами.
Посчитайте свой файл
Загрузите выгрузку продаж по месяцам и посмотрите, какая часть вашего ассортимента на самом деле предсказуема. Расчёт идёт прямо в браузере — файл никуда не отправляется.
Открыть XYZ-анализ