Почему одного коэффициента вариации мало
XYZ-анализ меряет одно число — насколько продажи разбегаются вокруг своего среднего. Это честный ответ на честный вопрос, но у него есть предел: разброс не говорит, откуда он взялся.
Возьмём четыре позиции из демонстрационной выгрузки. Все четыре по XYZ попадают в один класс — Z:
- соус соевый, коэффициент вариации 44,7 %: продажи растут почти каждый месяц, с 156 штук в январе до 739 в декабре;
- кофе зерновой смесь 60/40, 76,8 %: зимой около 1200 штук в месяц, в июле 8581 — ровно в семь раз больше, к декабрю снова 1051;
- сахар белый, 81,5 %: девять месяцев спада со 199 штук до 26, последние три месяца — ноль;
- крупа кускус, 111,5 %: пять месяцев нулей, потом продажи с 29 до 259 штук.
Одна буква на четыре совершенно разные ситуации. Растущую позицию надо закупать с опережением, сезонную — к сезону, затухающую распродать, а новинку не трогать и дать ей набрать обороты. Буква Z обо всём этом молчит — и не потому, что метод плохой, а потому, что он отвечает на другой вопрос.
Инструмент считает по тем же вашим столбцам ещё несколько величин, чтобы эти случаи различать. О них и статья.
Тренд: прямая по точкам и доверие к ней
Первое, что можно вытащить из ряда, — направление. По точкам проводится прямая методом наименьших квадратов:
xᵢ = a + β · tᵢ
- xᵢ
- продажи в периоде номер i
- tᵢ
- номер периода, от 0 до N − 1
- a
- свободный член, уровень в начале ряда
- β
- наклон: на сколько штук в среднем меняются продажи за период
Сам наклон в штуках сравнивать между позициями нельзя: +50 штук в месяц для позиции, которая продаётся тысячами, — это шум, а для той, что расходится десятками, — взрывной рост. Поэтому наклон делится на среднее и превращается в проценты за период: β / μ. Именно это число инструмент и называет трендом.
Но у наклона есть коварное свойство: он есть всегда. Через любое облако точек проходит какая-нибудь прямая, и если смотреть только на неё, рваный спрос легко объявить спадом и отправить позицию на вывод. Поэтому направление признаётся не по наклону, а по тому, насколько прямая вообще объясняет ваши данные:
R² = 1 − SSres / SStot
- SSres
- сумма квадратов отклонений точек от прямой, то, что прямая не объяснила
- SStot
- сумма квадратов отклонений точек от среднего, весь разброс целиком
- R²
- доля объяснённого разброса: 1 — точки лежат на прямой, 0 — прямая не объясняет ничего
Пороги по умолчанию такие. Тренд вообще считается от трёх периодов и только при ненулевом среднем. Направление признаётся при R² не меньше 0,5: ниже — прямая объясняет меньше половины разброса, и инструмент говорит «направления нет». Дальше смотрится сам наклон: рост — больше +5 % за период, спад — меньше −5 %, между ними — ровно.
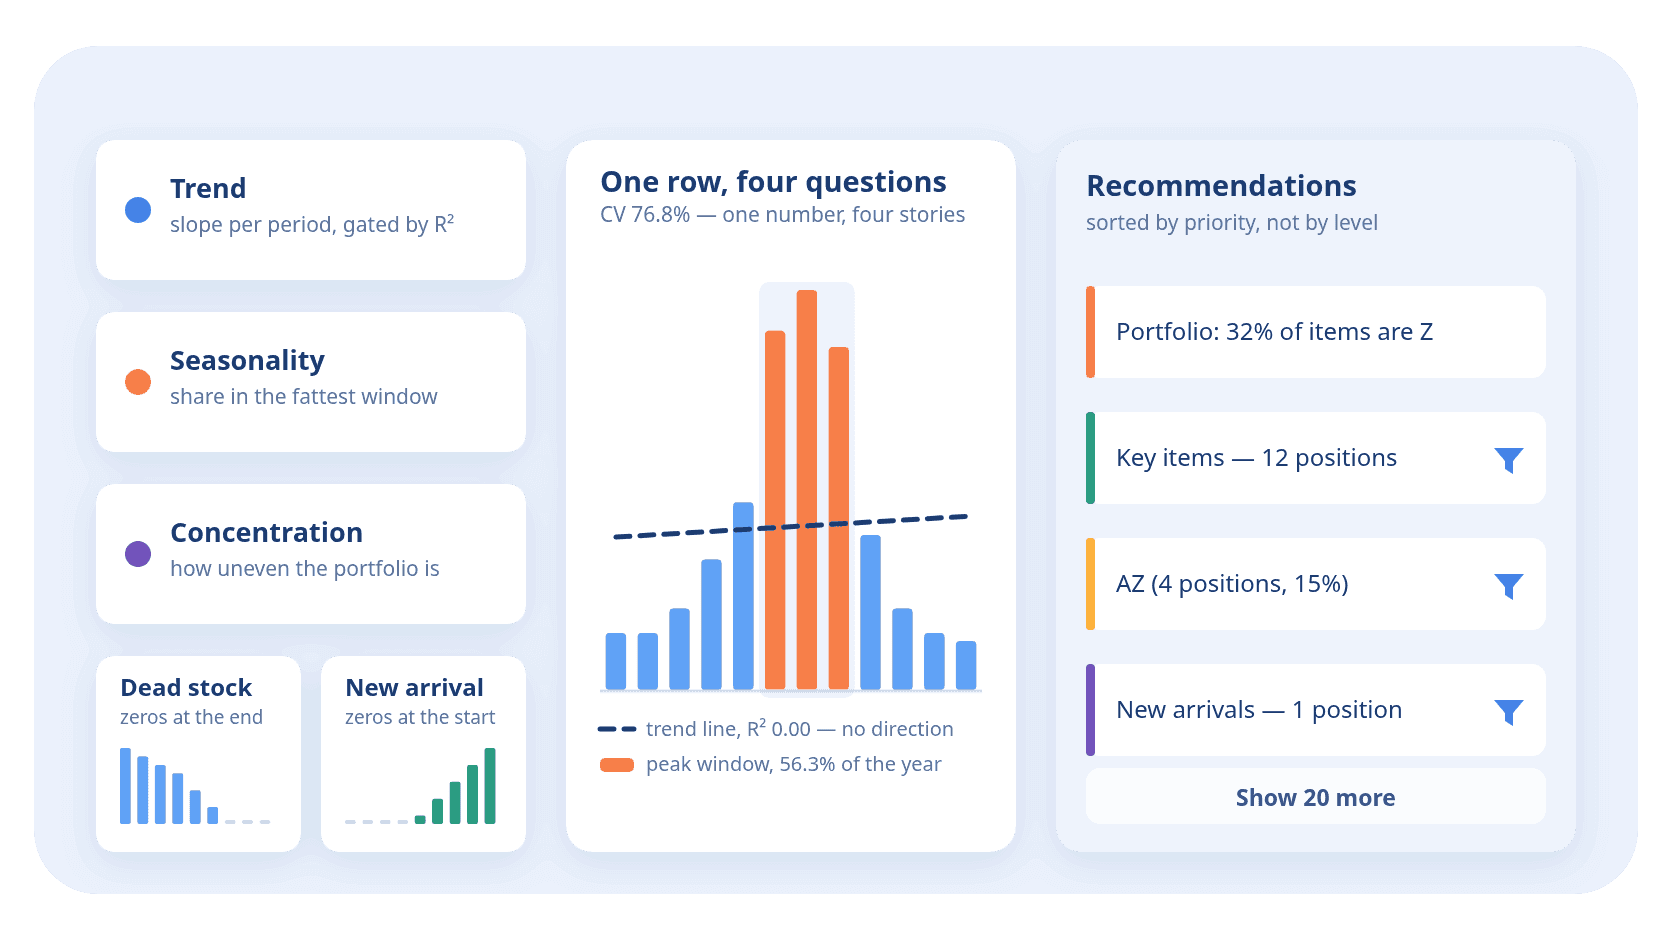
На демонстрационной выгрузке это видно на двух позициях. У соуса соевого наклон +12,8 % за месяц при R² 0,97 — прямая проходит почти по точкам, и позиция признаётся растущей. У кофе наклон тоже положительный, +1,2 % за месяц, но R² равен 0,00: летний горб и зимний провал прямая не объясняет вовсе. Направление не признаётся — и правильно, потому что никакого роста там нет.
Из 120 позиций выгрузки направление признано ровно у трёх: две растут, одна затухает. Остальные 117 — «ровно», и это нормальный результат: у большинства позиций тренда действительно нет.
Сезонность: самое «жирное» непрерывное окно
Коэффициент вариации не отличает сезонную позицию от рваной — обе колеблются. Различает их не размах, а где лежит объём: у сезона это несколько идущих подряд периодов, у рваного спроса — разрозненные всплески.
Поэтому по ряду скользит непрерывное окно, и считается доля объёма, попавшая в самое «жирное» из них:
P = Sw / S
- P
- доля пика: сколько объёма собралось в лучшем окне
- Sw
- объём лучшего окна: самого «жирного» отрезка подряд идущих периодов
- S
- объём за весь ряд: сумма всех периодов строки
Пороги: сезонность считается от шести периодов — на более коротком ряду «окно в четверть» вырождается. Позиция признаётся сезонной, если в пиковое окно попало 45 % объёма и больше.
У кофе из выгрузки в окно июнь–август попало 56,3 % годовых продаж — это сезонная позиция, и именно поэтому её нельзя планировать по среднему за год.
А теперь честная оговорка, без которой этот раздел был бы обманом. На одном годе данных метрика видит не сезон, а пиковость: разовая летняя акция выглядит точно так же, как повторяющийся из года в год сезон. Чтобы отличить одно от другого, нужно минимум два цикла и проверка на повторяемость — этого инструмент сегодня не делает.
Следствие видно на той же выгрузке. Флаг сезонности получают три позиции, и только у одной он про сезон:
- у кофе пиковое окно — июнь–август, настоящий летний подъём;
- у сахара лучшее окно пришлось на январь–март с долей 52,5 % — но это не сезон, а просто начало девятимесячного спада: в начале года продавалось больше всего, потому что дальше было только меньше;
- у кускуса окно — октябрь–декабрь, 67,1 %: это не сезон, а первые месяцы жизни новинки.
Инструмент частично себя страхует: в подсказку про пик мёртвый запас не попадает, поэтому сахар до неё не доходит. А новинка доходит — и читать её карточку нужно вместе с карточкой про новинки.
Мёртвый запас и новинка: одинаковые нули, разные решения
Две позиции могут иметь одинаковую долю нулевых периодов и требовать противоположных действий. Всё решает, где именно стоят нули.
Инструмент считает три вещи: сколько всего периодов без продаж, сколько их подряд в конце ряда и сколько в начале.
Мёртвый запас — это позиция, по которой продаж нет три периода подряд и больше, или такая, где нулей 70 % и больше при отсутствии продаж в последнем периоде. Сахар из выгрузки попадает по первому условию: последние три месяца по нулю. Решение — распродать остатки и не пополнять.
Новинка — зеркальный случай: нули в начале ряда, а продажа есть в последнем периоде или предпоследнем. Кускус попадает точно: пять нулей в начале и растущие продажи до декабря. Решение противоположное — не выводить, дать набрать обороты и не судить по классу, который она получила на неполном годе.
Доля нулей у них при этом близка — три против пяти из двенадцати, — и правило, построенное на одной этой доле, отправило бы новинку на вывод вместе с мёртвым запасом. Поэтому все признаки здесь привязаны к свежести: важно не сколько нулей, а с какой они стороны.
Концентрация портфеля: насколько неровно устроен список
Предыдущие метрики смотрят на одну строку. Эта — на весь список сразу и отвечает на вопрос, насколько неравномерно распределён вклад.
Считаются четыре числа:
- сколько позиций набирают 80 % объёма — в демонстрационной выгрузке 24 позиции из 120, то есть 20 % списка. Это почти буквальное правило 80/20;
- доля самой крупной позиции — 7,0 %;
- доля топ-10 % позиций — двенадцать самых крупных дают 57,4 % объёма;
- коэффициент Джини — 0,735. Это мера неравенства: ноль означал бы, что все позиции продаются одинаково, а предел для списка из 120 позиций — 0,992, когда всё держится на одной строке.
Сами по себе эти числа ничего не предписывают — они говорят, какого рода у вас ассортимент. Если 80 % набираются двумя позициями, вы зависите от двух поставок. Если восьмьюдесятью — хвост слишком длинный, и работа с ним по одной позиции не окупится. Именно эти числа стоят за подсказками вроде «структура сбалансирована» или «раздутый хвост».
Где это видно в интерфейсе
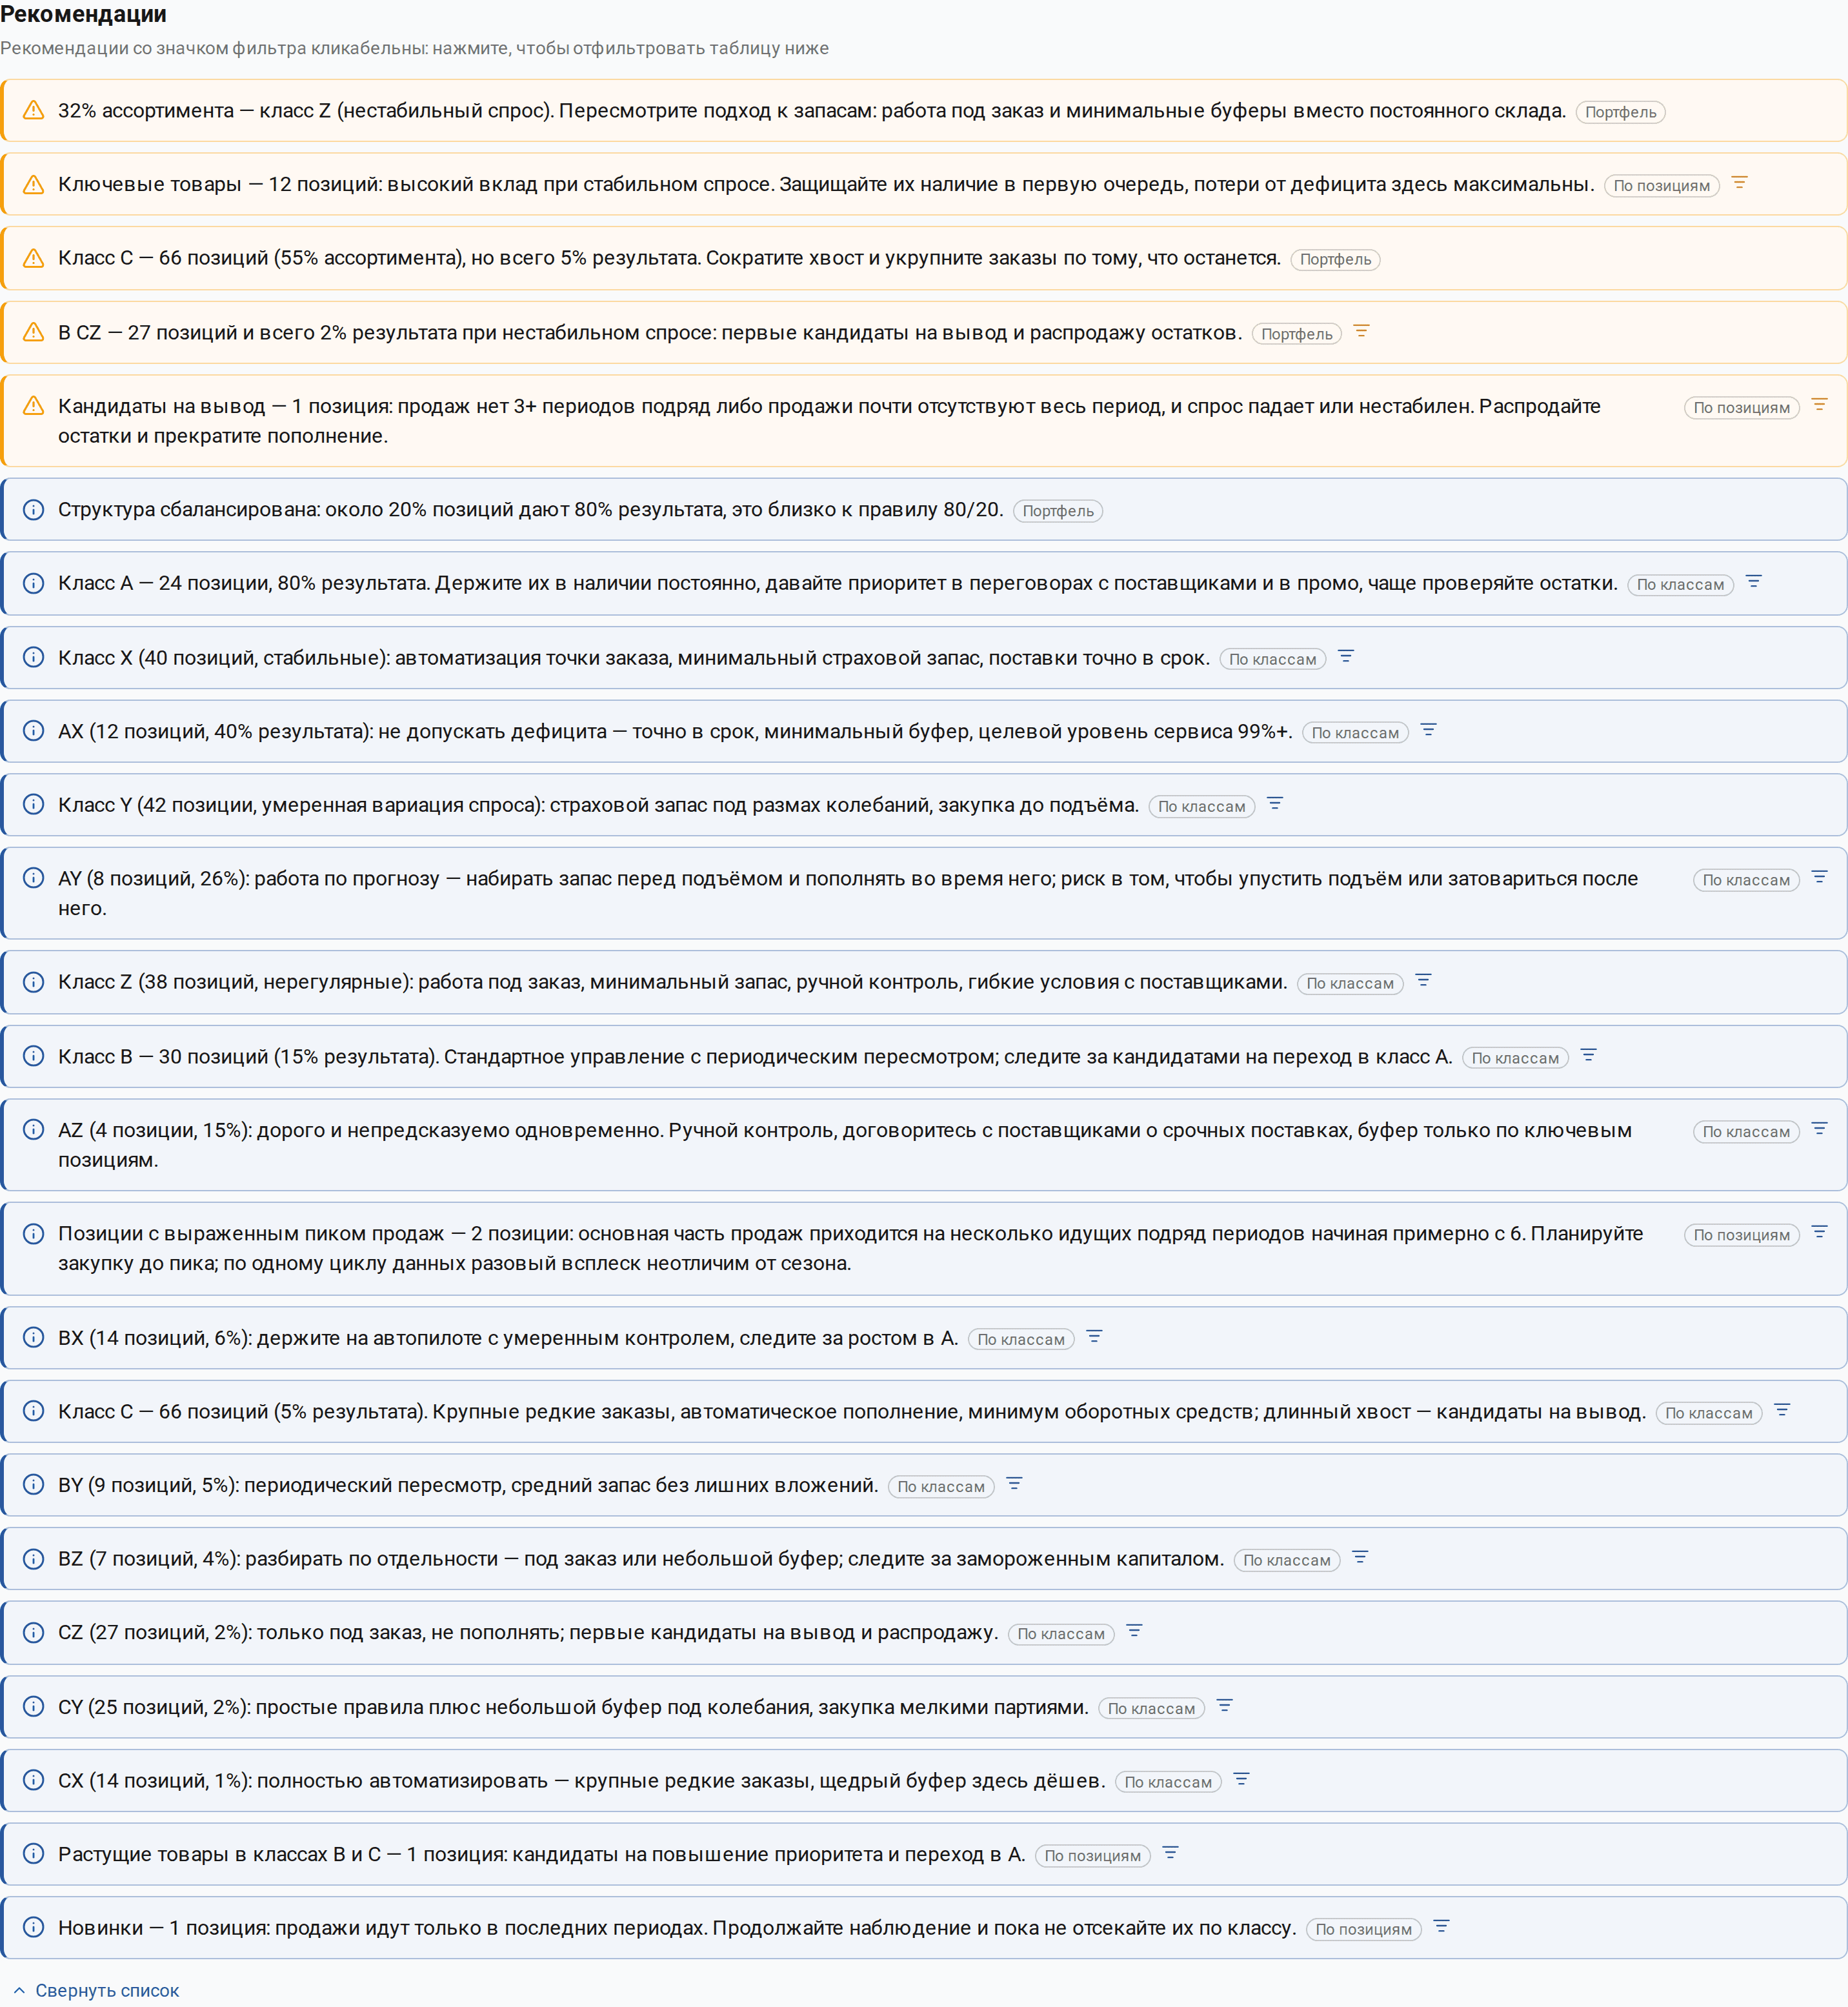
Под таблицей отчёта инструмент показывает панель подсказок. Ни одна из описанных выше метрик не становится столбцом отчёта и не попадает в выгрузку — ни тренда, ни R², ни доли пикового окна там нет. Они живут только здесь, в формулировках карточек.
Как устроена панель:
- Список плоский и отсортирован по важности, а не сгруппирован по уровню: сначала критичное, потом остальное по величине вклада. Группировка увела бы важную находку вниз, под общие рассуждения о структуре.
- По умолчанию видны первые четыре карточки, остальные — за кнопкой «Показать ещё». На демонстрационной выгрузке инструмент выдал 24 подсказки, то есть под кнопкой остаётся двадцать.
- На каждой карточке помечен уровень — «Портфель», «По классам» или «По позициям».
- Карточку со значком фильтра можно нажать, и таблица под ней покажет только те строки, о которых карточка говорит. Нажимаются те, за которыми стоит конкретный набор строк: на этой выгрузке 21 карточка из 24. Не нажимаются три, которые говорят про структуру списка целиком, — фильтровать там нечего, это весь список.
О чём бывают подсказки
Перечислять все не нужно — важнее понимать, на каких трёх уровнях они бывают.
Про портфель целиком. Сколько процентов ассортимента в классе Z, какую долю занимает хвост, близка ли структура к правилу 80/20, не раздут ли класс C. Это разговор о форме списка, и решения по ним стратегические: сокращать ассортимент, менять политику запасов.
Про классы и ячейки. Что делать с классом A, с классом X, с ячейкой AZ, с ячейкой CZ. Здесь подсказка повторяет то, что разобрано в статье про матрицу XYZ+ABC, но уже с вашими числами: сколько позиций в ячейке и какую долю результата они дают.
Про отдельные позиции. Ключевые товары, кандидаты на вывод, позиции с выраженным пиком, растущие позиции в младших классах, новинки. Это самые полезные карточки: за каждой стоит короткий список строк, который открывается одним нажатием.
Набор карточек зависит от ваших данных: если в выгрузке нет ни одной новинки, карточки про новинки не будет. Поэтому две разные выгрузки дают разные панели, и число 24 из примера выше — про этот файл, а не про инструмент.
Чего инструмент не делает
Список короткий, но важный — он очерчивает границу доверия.
- Не прогнозирует. Ни одна из метрик не говорит, сколько вы продадите в следующем месяце. Тренд — это описание прошлого, а не предсказание будущего.
- Не заказывает и не считает точку заказа. Подсказка говорит «держите страховой запас», но сколько именно держать, зависит от сроков поставки, кратности партии и уровня сервиса, которых в вашем файле нет.
- Не знает контекста. Акция, отсутствие товара на складе, уход крупного клиента, смена поставщика — всё это для инструмента просто числа в ячейках. Позиция, которой полгода не было в наличии, выглядит как затухающая, хотя спрос на неё никуда не делся.
- Не различает сезон и разовый всплеск на одном годе данных — об этом выше.
- Не видит ничего, кроме выбранных столбцов. Ни остатков, ни закупочных цен, ни маржи — если их нет в файле, их нет и в выводах.
Как этим пользоваться
Порядок, который работает.
- Сначала прочитать портфельные карточки — они дают картину целиком и заодно подсказывают, стоит ли вообще менять пороги анализа.
- Потом нажать позиционные и посмотреть сами строки. Карточка «кандидаты на вывод — 1 позиция» полезна ровно тем, что за ней стоит конкретная позиция, а не совет вообще.
- Проверить каждую находку своим знанием. Инструмент не знает, что кускус — новинка, которую вы завели месяц назад под конкретного клиента; он знает только, что нули стоят в начале. Совпало с вашей картиной мира — действуйте, не совпало — ищите причину в данных.
- Не принимать решения по одной карточке. «Позиция в CZ» и «позиция растёт» могут относиться к одной и той же строке и предлагать противоположное. Это не противоречие инструмента, а два разных среза одной ситуации, и выбирать между ними — ваша работа.
И главное: подсказки — это отсортированный список мест, куда стоит посмотреть, а не список команд. Их ценность в том, что они экономят просмотр ста двадцати строк, а не в том, что они принимают решение за вас.
Что дальше
Три статьи серии отвечают на три разных вопроса об одном и том же файле: насколько предсказуем спрос, сколько позиция даёт и что за этим стоит.
- Что такое XYZ-анализ — простыми словами — с чего всё начинается;
- XYZ+ABC-анализ: две буквы вместо одной — матрица из девяти ячеек и решения по каждой;
- Что такое ABC-анализ — простыми словами — вторая половина кода.
Посмотрите на свой файл
Загрузите продажи по месяцам и прочитайте подсказки под отчётом — они посчитаны по вашим периодам. Расчёт идёт прямо в браузере, файл никуда не отправляется.
Открыть XYZ+ABC-анализ